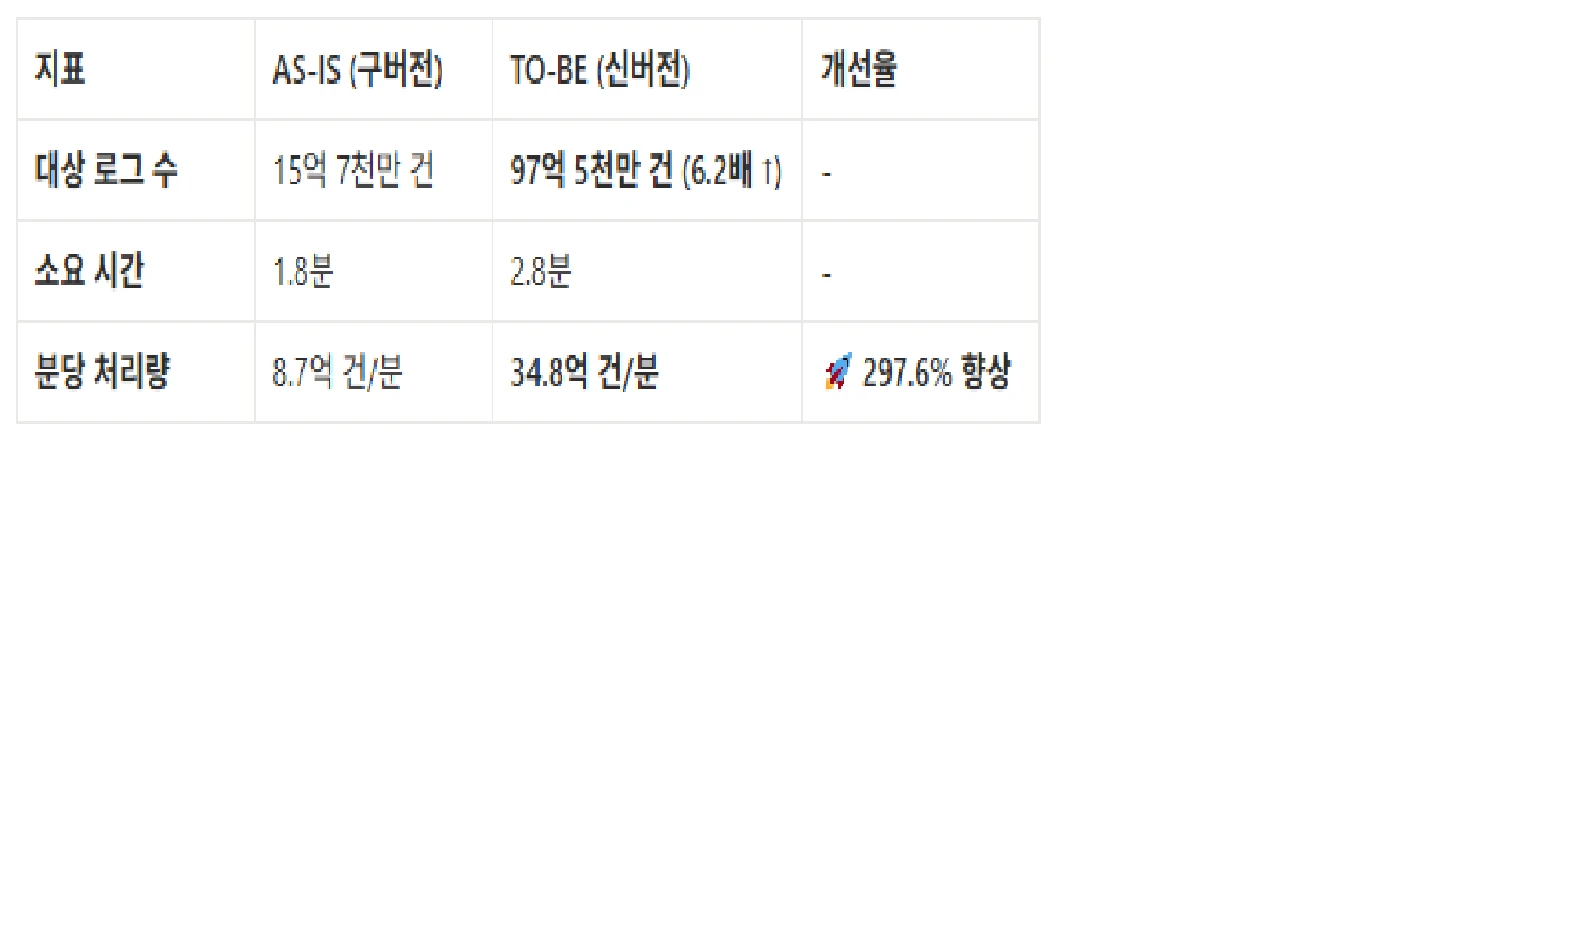
1. 문제상황 ** 배경 ** - 대용량 트래픽 처리를 검증하기 위해 **약 97억 건(기존 대비 6.2배)**의 로그를 적재하여 스트레스 테스트를 진행했습니다. 이 과정에서 기존 검색 엔진의 심각한 성능 한계가 드러났습니다. **주요 현상** - **Gateway Timeout (3분):** 대용량 데이터 검색 시 쿼리 응답이 3분을 초과하여 연결이 끊기는 현상 빈번 발생. - **UI Freezing:** 리스트(목록)와 통계(차트)를 동기식으로 호출하는 구조로 인해, 무거운 집계 연산이 끝날 때까지 화면 전체가 멈추는 사용자 경험 저하 또한 발생. 2. 기술적 원인 분석 기존 코드 분석 결과, 인덱싱 효율을 저하시키는 **Antipattern**을 발견했습니다. -1. Full Scan 유발 - 모든 필드에 대해 `keyword*` (Leading Wildcard) 검색 수행. - 숫자형 데이터(Port, SID)까지 문자열로 처리하여 인덱스 탐색 효율 저하. -2. 고비용 집계 연산 - 단순 요약 정보를 위해 4개 필드(`Src/Dst IP`, `Port`)에 대해 동시에 **Cardinality(고유 개수 계산)** 수행. - Cardinality는 메모리(HyperLogLog++)와 CPU를 과도하게 소모하며, 데이터 양에 비례해 부하가 급증함. 3. 해결 전략 전략 1: ES 쿼리 구조 최적화 - "무조건적인 전수 조사"에서 **"타입별 최적화 및 표본 조사"**로 패러다임을 전환했습니다. 전략 2: 쿼리 분리 및 병렬 처리 - **Query Splitting:** 무거운 집계(Aggs, Size: 0)와 가벼운 리스트(Hits, Size: 1000) 쿼리를 물리적으로 분리. - **Parallel Execution:** 독립적인 비동기 호출로 리스트 데이터를 즉시 렌더링(TTFB 단축)하여 체감 속도 개선. 5. 정량적 성과 - 데이터 처리량 기준 약 297%의 성능 향상을 달성했습니다. $성과 의의$ 로그 데이터가 폭발적으로 증가하는 환경에서도 소프트웨어 레벨의 튜닝(Cardinality 제거, Term 쿼리, 병렬 아키텍처)만으로 시스템의 처리 한계를 획기적으로 확장했습니다.
웹 페이지 성능 개선

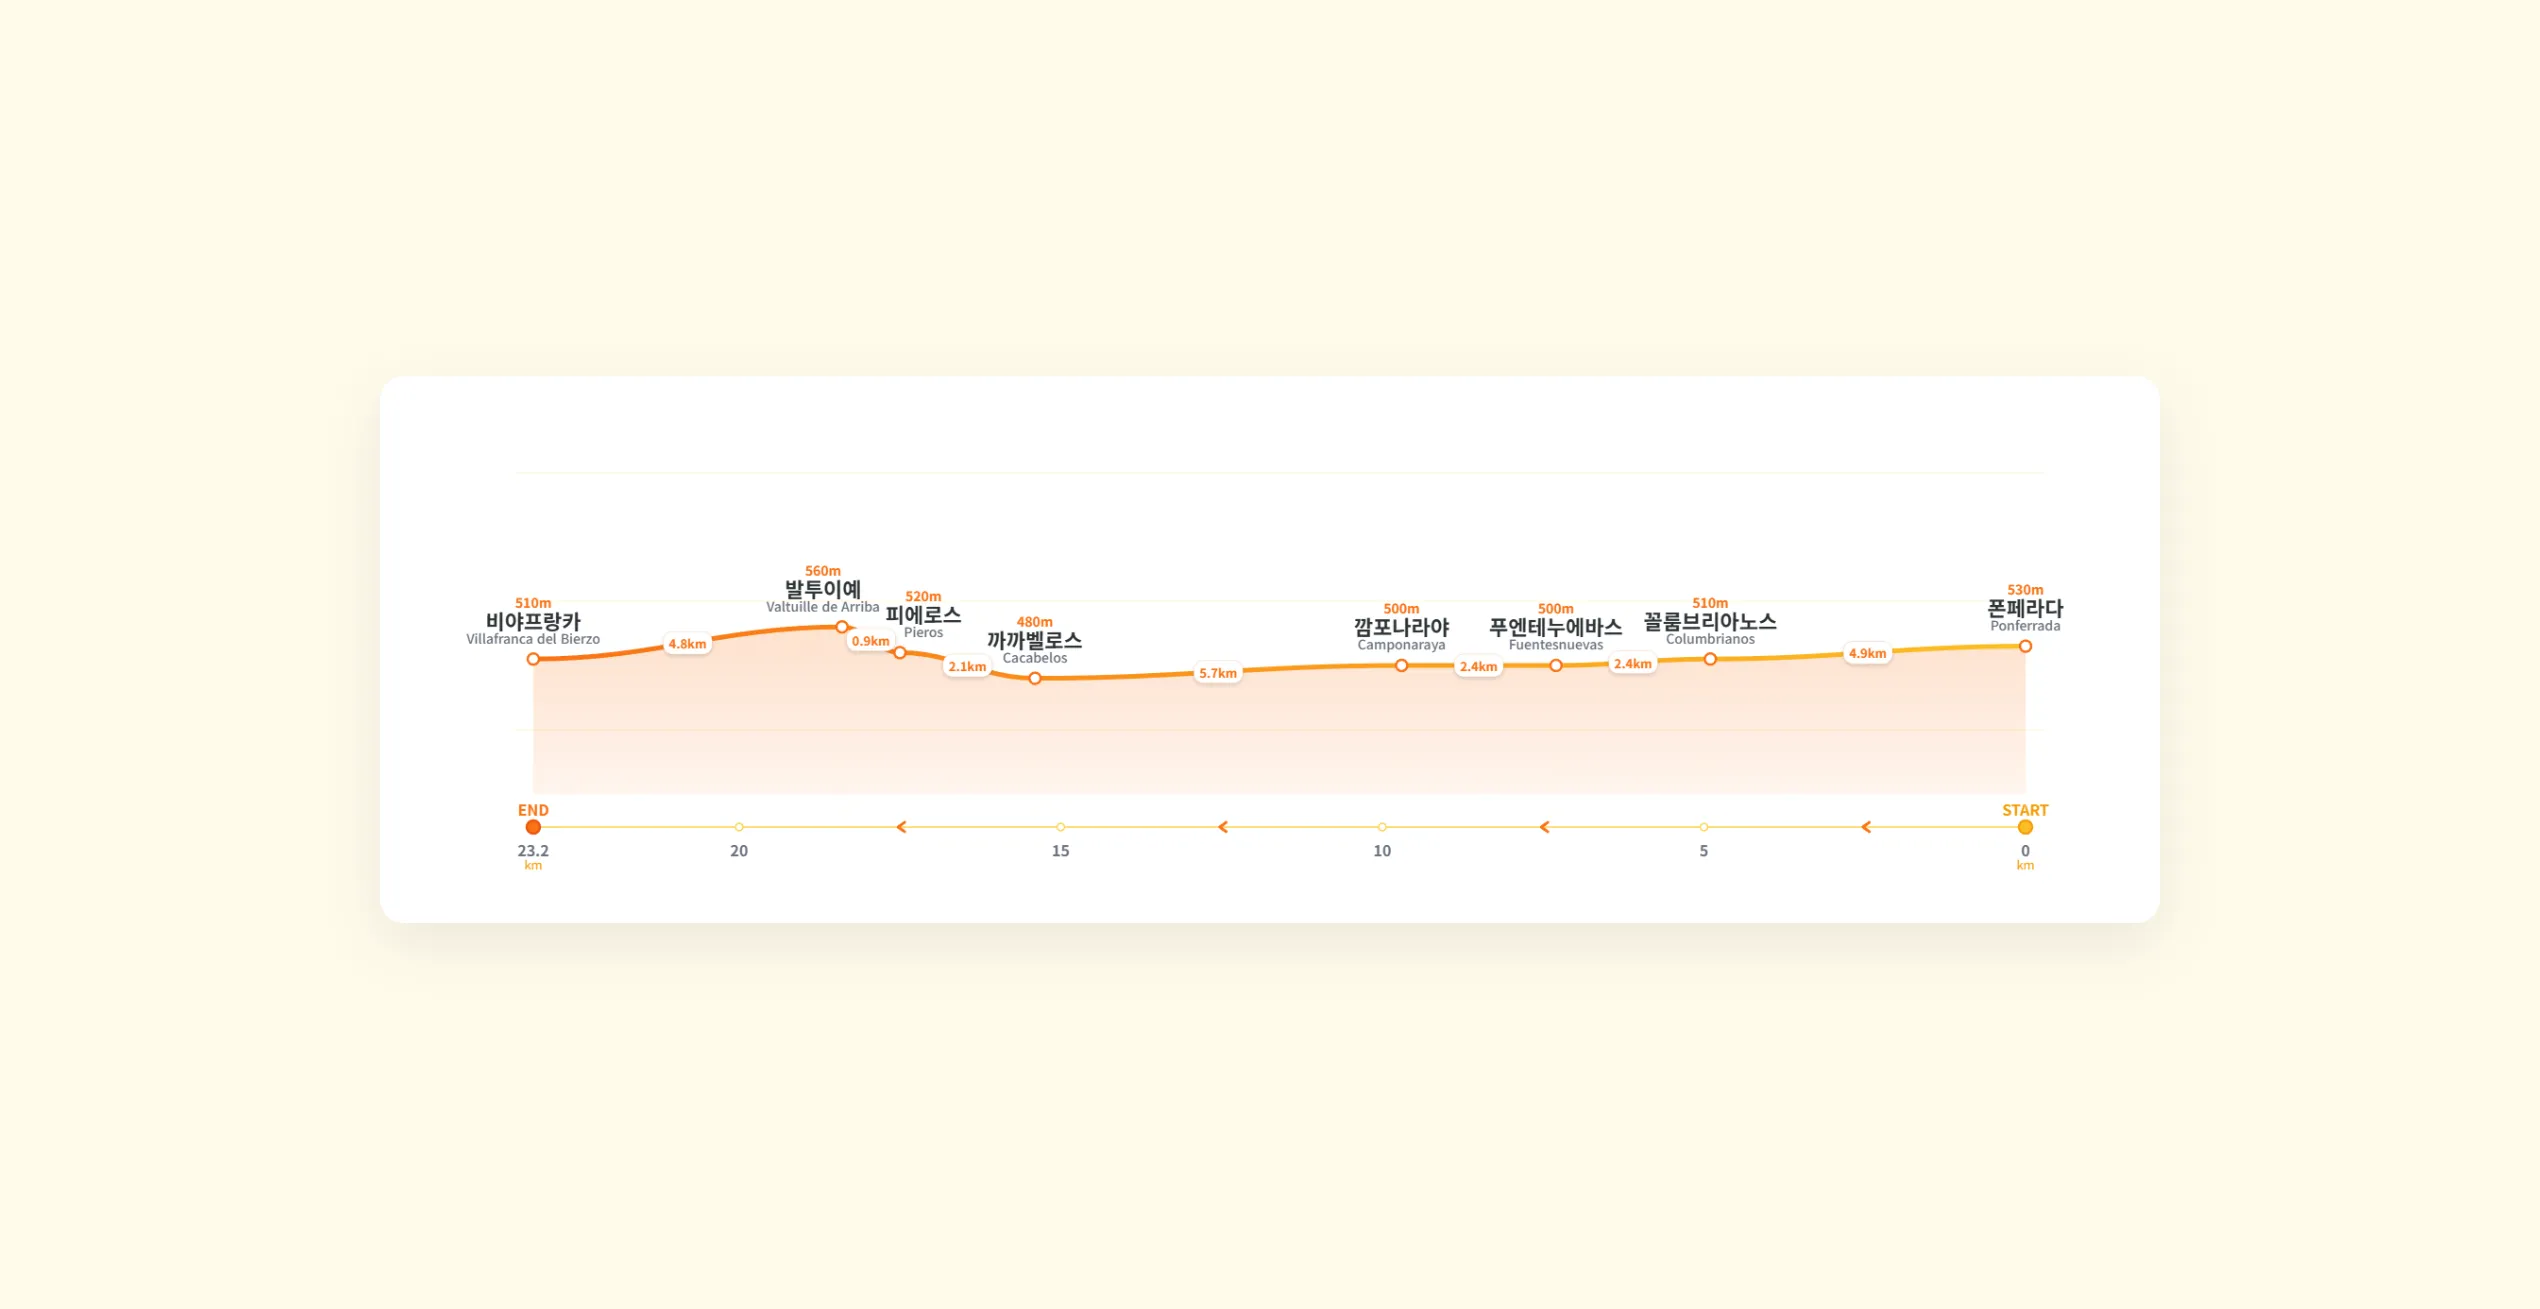
Camini de Santiago 고도 그래프 시각화 프로젝트
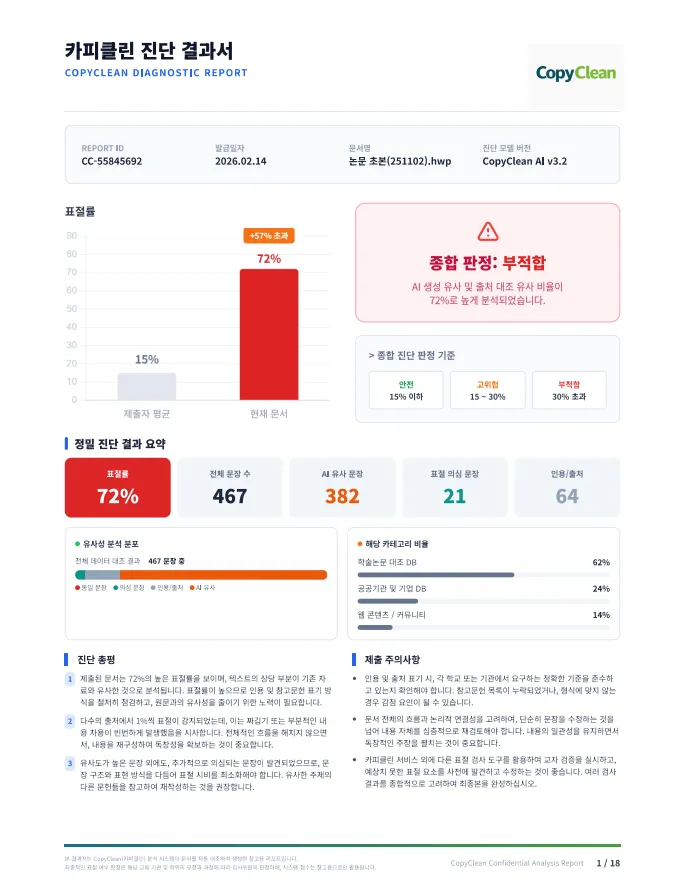
AI 기반 표절 분석 웹 앱: CopyKiller PDF를 전문가 리포트로 재탄생
Camini de Santiago 고도 그래프 시각화 프로젝트
02AI 기반 표절 분석 웹 앱: CopyKiller PDF를 전문가 리포트로 재탄생
02
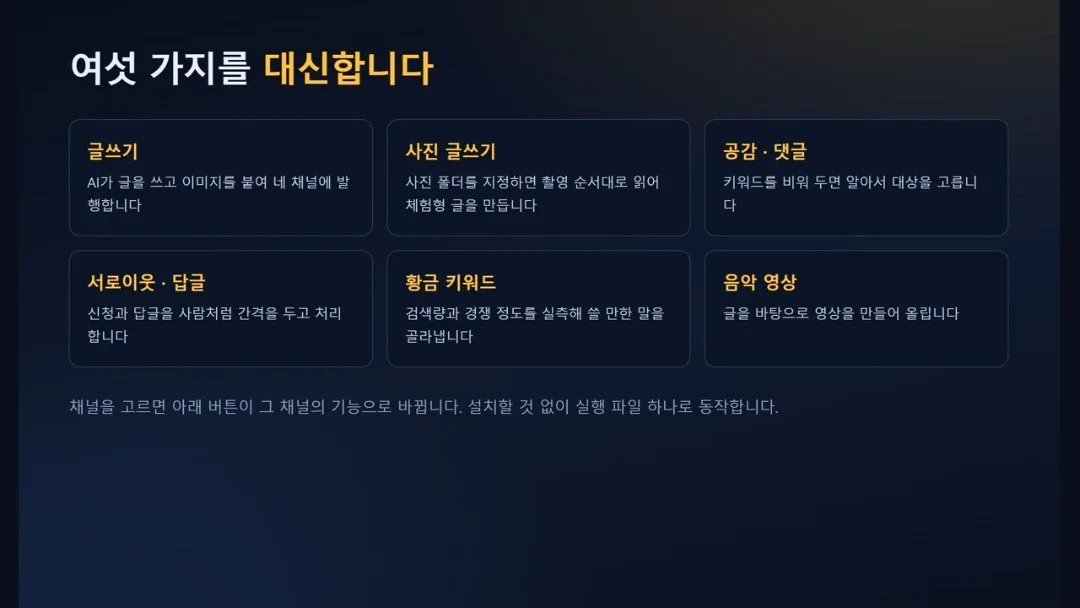
글 하나를 쓰면 네 개 채널에 자동으로 발행되고, 공감과 댓글, 서로이웃, 답글까지 처리하는 프로그램을 직접 설계하고 개발했습니다. 채널마다 API 규격과 인증 방식, 이미지 처리 방식이 전부 다릅니다. 채널을 추가할 때마다 본체를 고쳐야 하는 구조를 피하려고, 발행 로직을 채널별로 분리하고 공통 인터페이스만 지키도록 설계했습니다. 가장 어려웠던 것은 발행이 아니라 실패 처리였습니다. 초기에는 한 채널이 막히면 전체가 멈췄습니다. 채널별로 독립 재시도하도록 바꾸고, 실패 원인을 인증 만료와 일시 오류로 구분한 뒤에야 무인 운영이 가능해졌습니다. 로그인은 일부러 자동화하지 않았습니다. 프로그램이 반복 로그인하면 캡차가 뜨고 계정이 막히기 때문입니다. 처음 한 번 사용자가 직접 로그인하면 그 세션을 저장해 씁니다. 속도도 일부러 늦췄습니다. 사람처럼 간격을 두고 움직이도록 만들었습니다. 짧은 시간에 몰아서 처리하면 하루 만에 막힙니다. 파이썬으로 개발했고 설치 없이 실행 파일 하나로 동작합니다. 계정 정보는 사용자 PC에만 암호화 저장되며 외부로 전송되지 않습니다. ※ 각 블로그 서비스의 이용약관을 준수하는 범위에서 동작하며, 방문자 수나 노출 순위 등의 결과를 보장하지 않습니다.
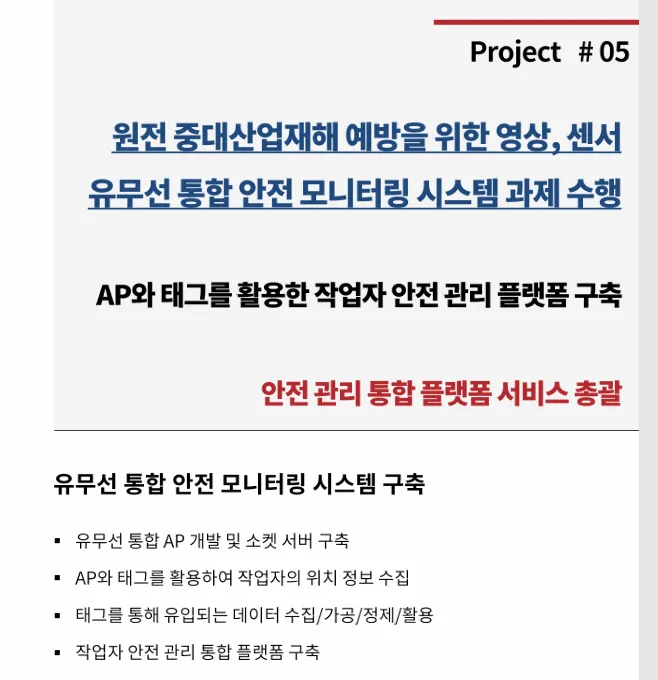
원전 중대산업재해 예방을 위한 정부 과제 수행

헤어샵 챗봇

일일공사현황
글 하나를 쓰면 네 개 채널에 자동으로 발행되고, 공감과 댓글, 서로이웃, 답글까지 처리하는 프로그램을 직접 설계하고 개발했습니다. 채널마다 API 규격과 인증 방식, 이미지 처리 방식이 전부 다릅니다. 채널을 추가할 때마다 본체를 고쳐야 하는 구조를 피하려고, 발행 로직을 채널별로 분리하고 공통 인터페이스만 지키도록 설계했습니다. 가장 어려웠던 것은 발행이 아니라 실패 처리였습니다. 초기에는 한 채널이 막히면 전체가 멈췄습니다. 채널별로 독립 재시도하도록 바꾸고, 실패 원인을 인증 만료와 일시 오류로 구분한 뒤에야 무인 운영이 가능해졌습니다. 로그인은 일부러 자동화하지 않았습니다. 프로그램이 반복 로그인하면 캡차가 뜨고 계정이 막히기 때문입니다. 처음 한 번 사용자가 직접 로그인하면 그 세션을 저장해 씁니다. 속도도 일부러 늦췄습니다. 사람처럼 간격을 두고 움직이도록 만들었습니다. 짧은 시간에 몰아서 처리하면 하루 만에 막힙니다. 파이썬으로 개발했고 설치 없이 실행 파일 하나로 동작합니다. 계정 정보는 사용자 PC에만 암호화 저장되며 외부로 전송되지 않습니다. ※ 각 블로그 서비스의 이용약관을 준수하는 범위에서 동작하며, 방문자 수나 노출 순위 등의 결과를 보장하지 않습니다.
COSMOS032원전 중대산업재해 예방을 위한 정부 과제 수행
권민정03헤어샵 챗봇
다솜엑스093일일공사현황
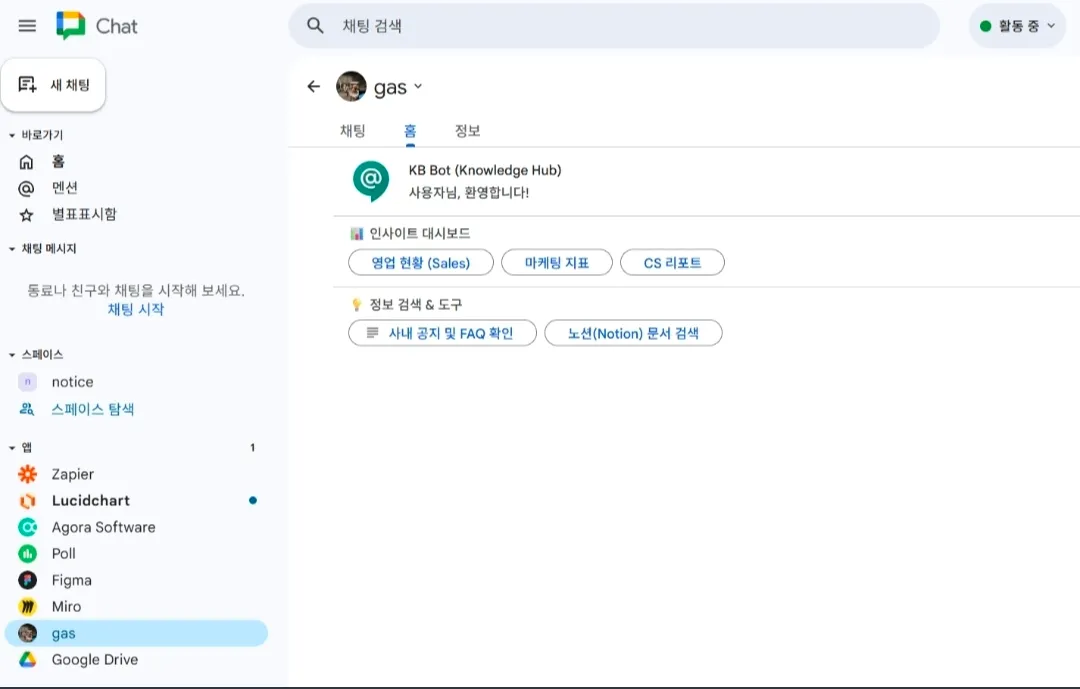
Ex커스텀099구글 생태계 챗봇 및 대시보드 제작
구글짱 010
바이브코딩 개발
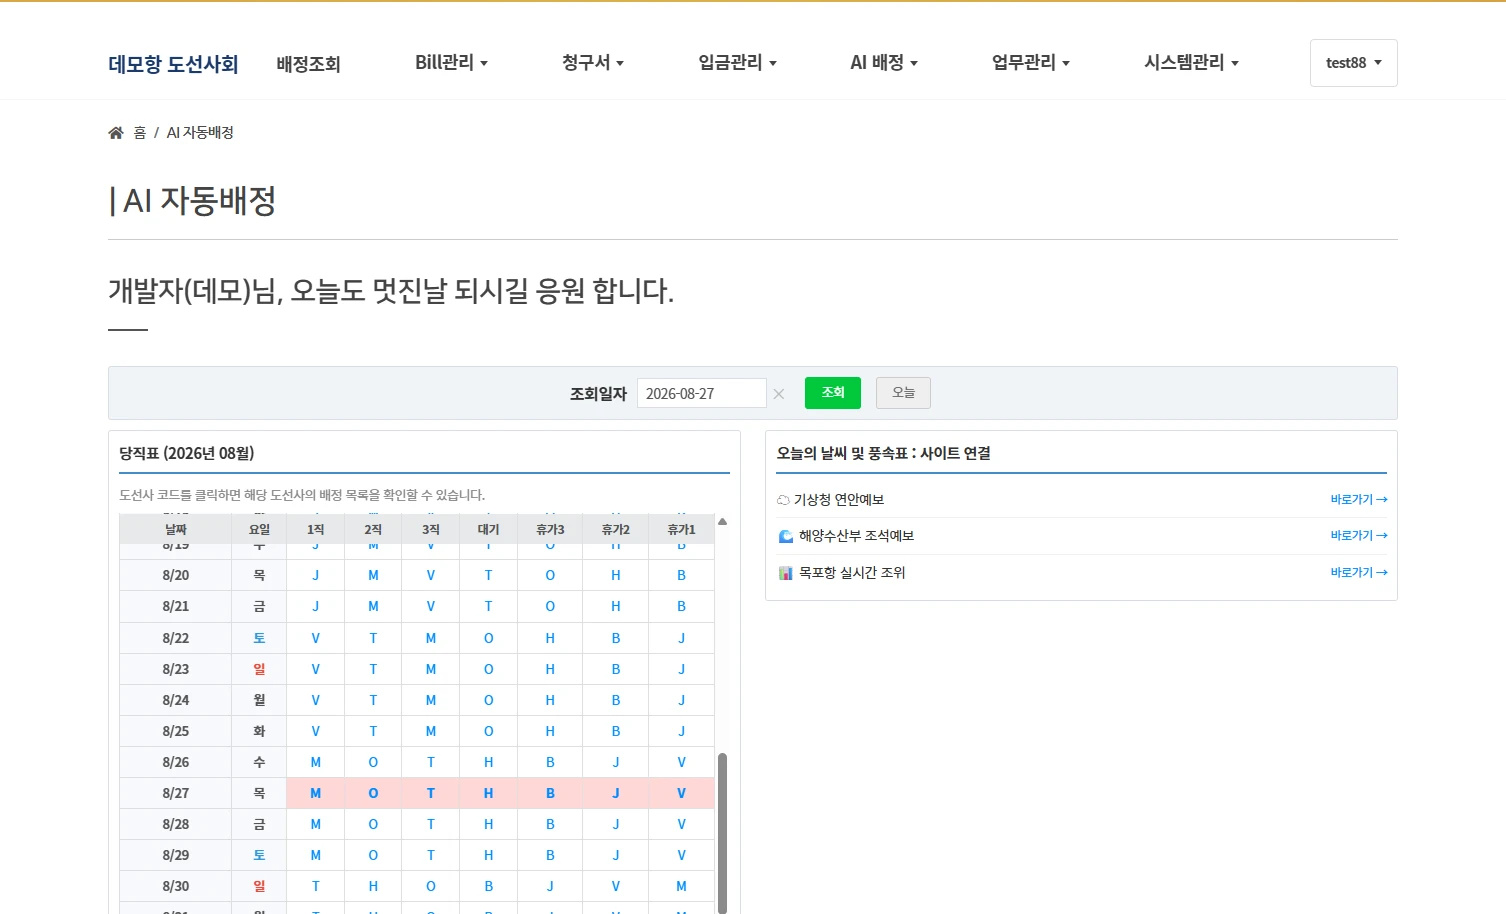
박강원04AI가 매일 당직 순서대로 도선사 배정을 제안
업무설계자 | 맞춤 시스템과 AI 자동화 05
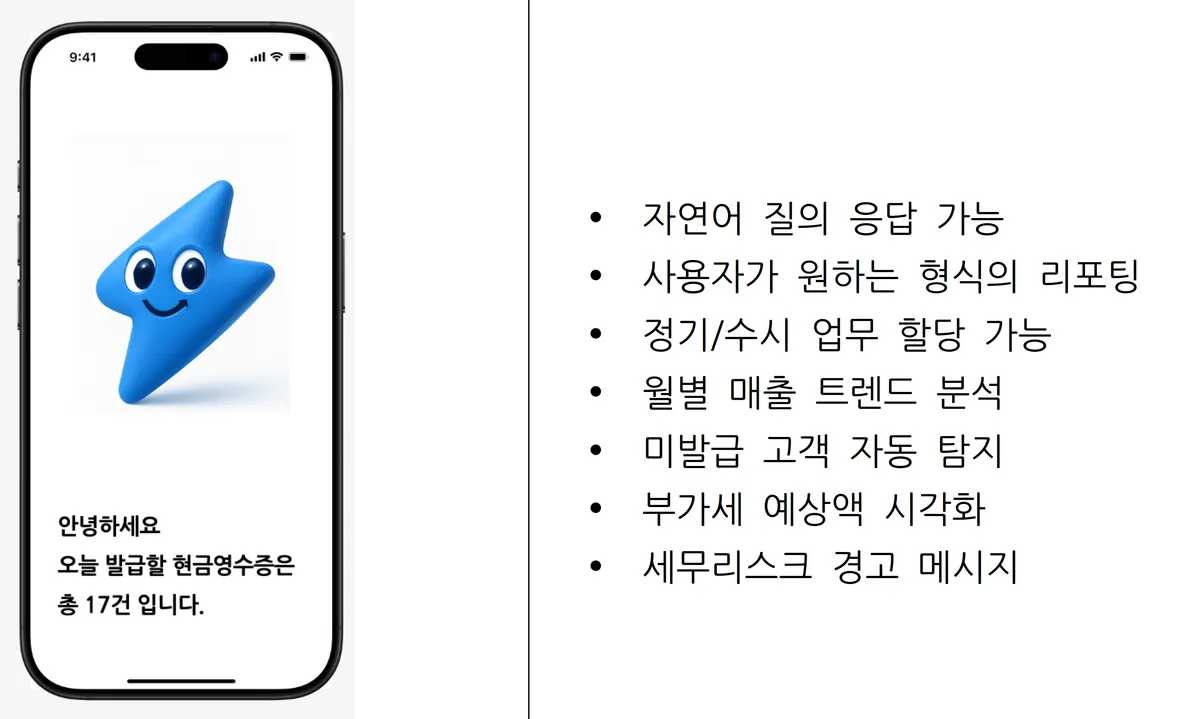
현금영수증 자동발급 웹앱 SasS (캐시오토)
(주)니보라-LG전자(10년),풀스택 개발 연구원 출신 014
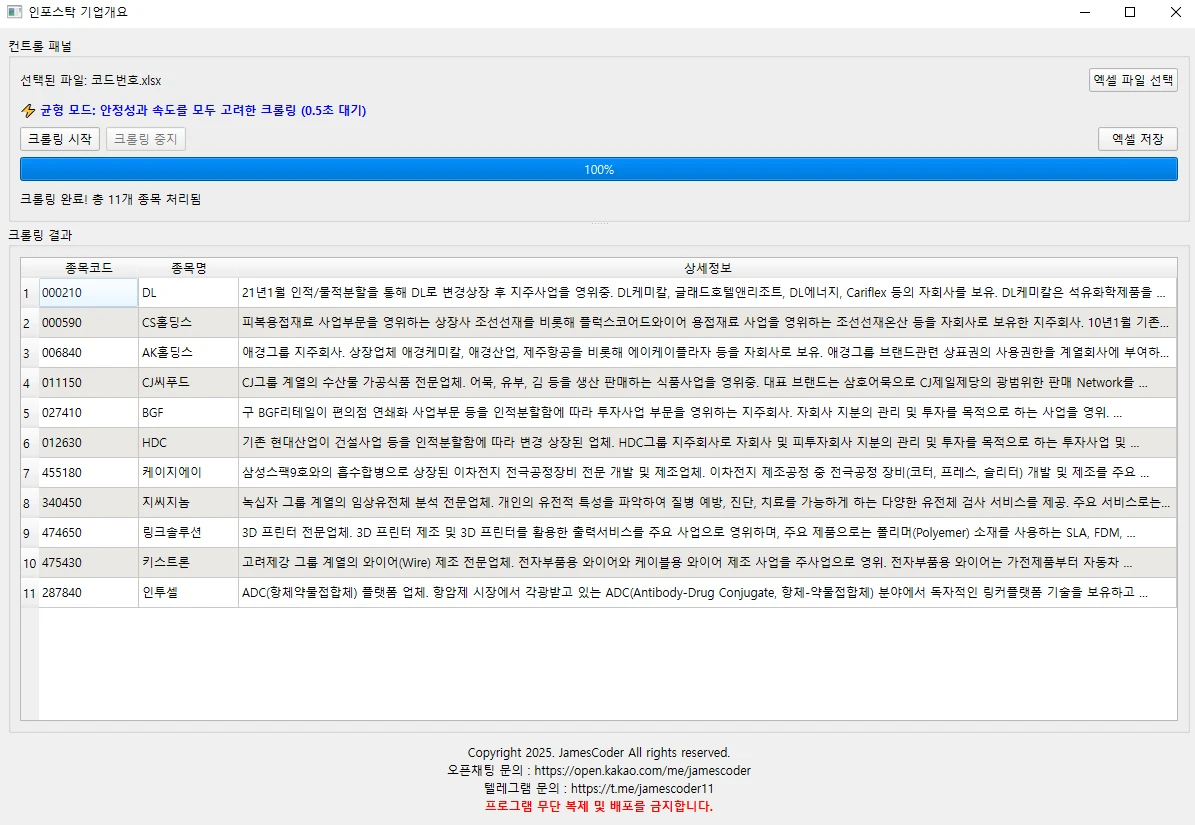
기업에 대한 상세정보를 크롤링해주는 프로그램
JamesCoder 034